卷积神经网络是怎么「看懂」一张岩土图像的?
卷积神经网络是怎么看懂一张边坡图像的? 给神经网络一张边坡照片,它能不能自动找到上面的裂缝? 对人来说,这件事似乎不难。看到坡面上一条细长、颜色较深、形态不规则的线条,我们通常就能判断那里可能存在裂缝。 但对于计算机来说,一张照片并不是一处边坡,而是一组数字。 比如一张 512×…
卷积神经网络是怎么看懂一张边坡图像的?
给神经网络一张边坡照片,它能不能自动找到上面的裂缝?
对人来说,这件事似乎不难。看到坡面上一条细长、颜色较深、形态不规则的线条,我们通常就能判断那里可能存在裂缝。
但对于计算机来说,一张照片并不是一处边坡,而是一组数字。
比如一张 512×512 的 RGB 图像,本质上就是一个包含三个颜色通道的数值矩阵。计算机并不知道哪里是岩石、哪里是植被,更不知道哪一条线代表裂缝。
那么问题来了:
卷积神经网络(CNN)究竟是怎么从一堆像素中,逐渐学会识别边坡裂缝的?
这篇不讲复杂的数学推导,就从一张边坡图像出发,看看 CNN 到底做了什么,再用 PyTorch 搭建一个简单的裂缝分割网络。
一、先从人眼说起:我们是怎么找到裂缝的?
拿到一张边坡照片,我们通常不会逐个像素去检查。
而是先看整体坡面,再关注局部区域,最后寻找具有裂缝特征的细长纹理。
例如:
- 坡面与周围环境之间的边界;
- 岩石表面的纹理和颜色变化;
- 细长、不规则的线状结构;
- 裂缝之间的分布关系。
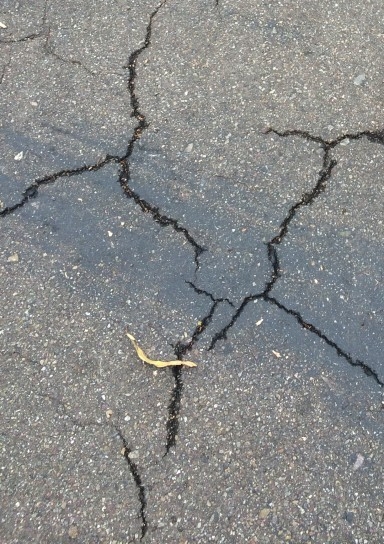
它不会一开始就知道什么是裂缝,而是通过大量带有标注的图像,不断调整网络中的参数,逐渐学习哪些视觉特征有助于区分裂缝与背景。
这里可以把 CNN 的特征提取过程简单理解为三个阶段:
| 网络层级 | 主要学习的特征 | 在边坡图像中的表现 |
|---|---|---|
| 浅层卷积 | 边缘、颜色变化、方向信息 | 裂缝边缘、明暗交界 |
| 中层卷积 | 局部纹理、形状组合 | 裂缝分支、岩石纹理 |
| 深层卷积 | 更复杂的特征组合 | 有助于区分裂缝与背景的高层特征 |
注意,这不是说每一层都严格对应某一种特征,而是帮助理解网络逐层提取特征的过程。
那么,CNN 是如何提取这些特征的?
答案就是:卷积。
二、卷积层:给图像装上一个个小探测器
卷积核(Kernel)可以理解成一个小型特征探测器。
假设有一张边坡图像,卷积核会在图像上按照一定步长移动,对局部像素进行计算。
例如,一个 3×3 的卷积核:
    ┌          ┐
    │ 1  0  -1 │
K = │ 1  0  -1 │
    │ 1  0  -1 │
    └          ┘
它可以对某些方向的亮度变化产生响应。
当卷积核在整张图像上滑动时,就会得到一张新的特征图(Feature Map)。
可以简单理解为:
原始图像 → 卷积运算 → 特征图。
不同卷积核学习不同的权重,因此能够对不同的边缘、纹理和局部结构产生响应。
在训练过程中,这些卷积核的参数会根据损失函数的反馈不断更新。
也就是说,CNN 不需要我们提前告诉它哪种卷积核专门负责识别裂缝,它可以从训练数据中自动学习有用的特征。
这也是 CNN 相比传统手工特征提取方法的一个重要优势。
三、池化层:为什么网络需要缩小图像?
如果一直在原始分辨率上进行卷积,计算量会比较大。
因此,CNN 通常会使用池化(Pooling)或者步长卷积,逐渐降低特征图的空间分辨率。
最常见的是最大池化(Max Pooling)。
例如:
┌     ┐
│ 1 3 │
│ 2 4 │  →  4
└     ┘
它从一个局部区域中选取最大值,减少特征图的尺寸。
这样做有两个主要作用:
- 降低后续网络的计算量;
- 扩大后续特征提取的感受野,让网络能够综合更大范围的信息。
但对于边坡裂缝识别来说,这里存在一个特殊问题。
裂缝往往很细,连续下采样可能直接丢失细小裂缝的特征。
例如,一条只有几个像素宽的裂缝,经过多次下采样后,可能变得非常模糊,甚至无法保留。
所以,实际进行边坡裂缝分割时,不能只关注网络提取高层特征的能力,还要考虑如何保留浅层的空间细节。
这就引出了一个非常经典的网络结构。
四、U-Net:为什么它特别适合裂缝分割?
如果任务只是判断一张边坡照片中有没有裂缝,普通 CNN 分类网络就可以完成。
但如果我们希望知道:
- 裂缝具体在哪里?
- 裂缝的边界是什么?
- 哪些像素属于裂缝?
那么就需要进行语义分割。
U-Net 是图像分割领域非常经典的一种网络结构。
它的整体结构看起来像一个字母 U:
左边负责提取特征,右边负责恢复空间分辨率,中间通过跳跃连接传递信息。
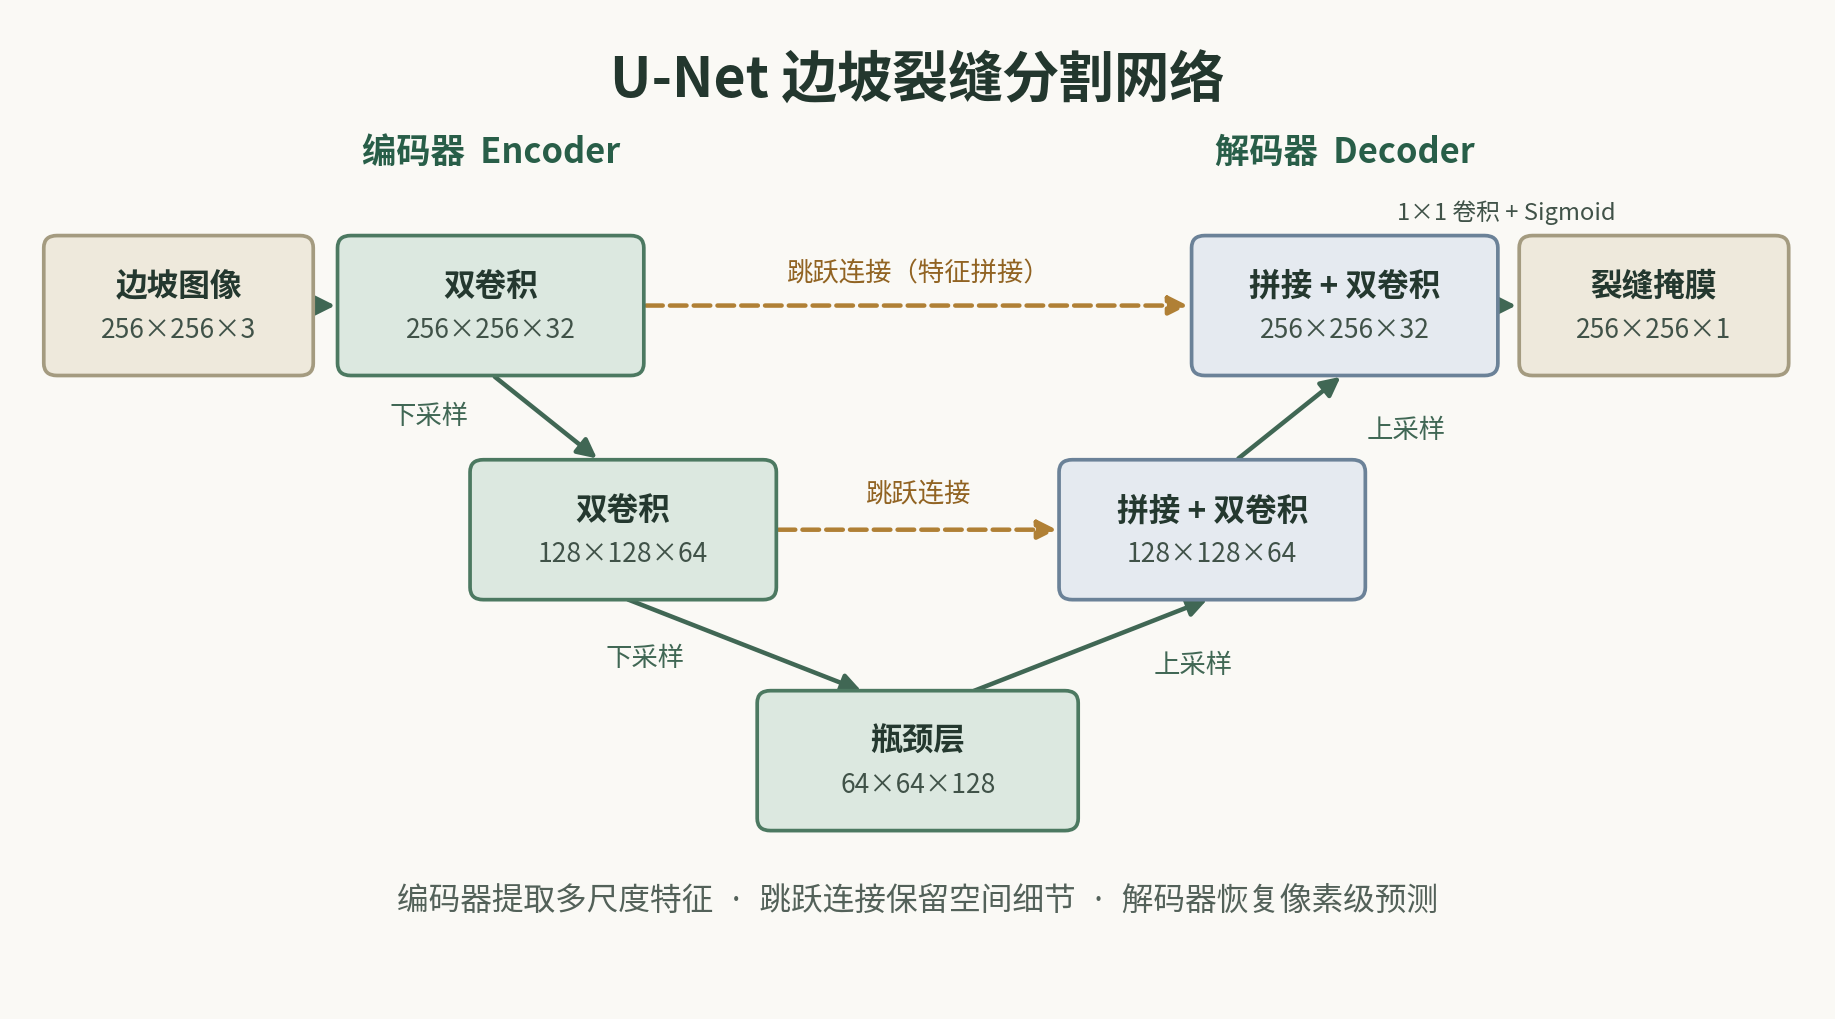
U-Net 主要包含三个部分:
1. 编码器(Encoder)
不断进行卷积和下采样,提取从简单边缘到复杂纹理的特征。
2. 解码器(Decoder)
逐步恢复特征图的空间分辨率,让网络能够定位裂缝所在的位置。
3. 跳跃连接(Skip Connection)
把编码器中对应层级的特征传递给解码器。
为什么需要它?
因为编码器虽然能够提取丰富的语义信息,但连续下采样容易损失裂缝的细节。
跳跃连接可以把浅层的空间信息与深层的语义信息结合起来。
对于细长、形态不规则的边坡裂缝来说,这一点尤其重要。
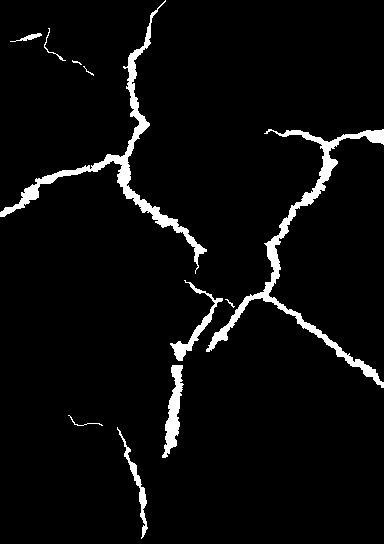
最终,网络输出一张与输入图像对应的预测掩膜:
- 白色区域:模型预测的裂缝;
- 黑色区域:模型预测的背景。
这就是从图像分类走向像素级裂缝识别的区别。
五、用 PyTorch 搭建一个简单的裂缝分割网络
原理讲完,直接看代码。
这里使用一个简化版 U-Net,完成边坡图像的二分类分割。
任务很明确:
输入一张边坡照片,输出一张裂缝掩膜。
数据集需要提前准备好,每张原图都要有对应的人工标注掩膜。
目录结构如下:
slope_crack_dataset/
├── train/
│   ├── images/
│   └── masks/
└── val/
    ├── images/
    └── masks/
其中,images 存放原始边坡照片,masks 存放对应的裂缝标注图。两者文件名保持一致,掩膜中白色代表裂缝,黑色代表背景。
1. 数据读取
import torch
import torch.nn as nn
import numpy as np

from pathlib import Path
from PIL import Image
from torch.utils.data import Dataset, DataLoader

class CrackDataset(Dataset):

    def __init__(self, root):
        self.root = Path(root)
        self.image_dir = self.root / "images"
        self.mask_dir = self.root / "masks"

        self.images = sorted(
            self.image_dir.glob("*")
        )

        self.samples = [
            (p, self.mask_dir / (p.stem + ".png"))
            for p in self.images
            if (self.mask_dir / (p.stem + ".png")).exists()
        ]

    def __len__(self):
        return len(self.samples)

    def __getitem__(self, index):
        image_path, mask_path = self.samples[index]

        image = Image.open(image_path).convert("RGB")
        mask = Image.open(mask_path).convert("L")

        image = image.resize(
            (256, 256), Image.Resampling.BILINEAR
        )

        mask = mask.resize(
            (256, 256), Image.Resampling.NEAREST
        )

        image = np.array(image, dtype=np.float32) / 255.0
        mask = np.array(mask, dtype=np.uint8)

        image = torch.from_numpy(image).permute(2, 0, 1)
        mask = torch.from_numpy(
            (mask > 127).astype(np.float32)
        ).unsqueeze(0)

        return image, mask
这里有几个细节:
- 原始图像统一调整为 256×256;
- 图像使用 RGB 三通道;
- 掩膜使用单通道;
- 原图采用双线性插值,掩膜采用最近邻插值,避免标签边界产生无效灰度值。
2. 定义 U-Net 网络
class DoubleConv(nn.Module):

    def __init__(self, in_channels, out_channels):
        super().__init__()

        self.block = nn.Sequential(
            nn.Conv2d(
                in_channels, out_channels, 3, padding=1
            ),
            nn.ReLU(inplace=True),

            nn.Conv2d(
                out_channels, out_channels, 3, padding=1
            ),
            nn.ReLU(inplace=True)
        )

    def forward(self, x):
        return self.block(x)


class UNet(nn.Module):

    def __init__(self):
        super().__init__()

        self.pool = nn.MaxPool2d(2)

        self.enc1 = DoubleConv(3, 32)
        self.enc2 = DoubleConv(32, 64)

        self.middle = DoubleConv(64, 128)

        self.up2 = nn.ConvTranspose2d(
            128, 64, 2, stride=2
        )

        self.dec2 = DoubleConv(128, 64)

        self.up1 = nn.ConvTranspose2d(
            64, 32, 2, stride=2
        )

        self.dec1 = DoubleConv(64, 32)

        self.output = nn.Conv2d(32, 1, 1)

    def forward(self, x):

        x1 = self.enc1(x)

        x2 = self.enc2(self.pool(x1))

        x3 = self.middle(self.pool(x2))

        y = self.up2(x3)
        y = torch.cat([y, x2], dim=1)
        y = self.dec2(y)

        y = self.up1(y)
        y = torch.cat([y, x1], dim=1)
        y = self.dec1(y)

        return self.output(y)
这段代码就是整个网络的核心。
注意最后一层:
self.output = nn.Conv2d(32, 1, 1)它将 32 个特征通道映射为一个输出通道。
每个像素对应一个预测值,经过 Sigmoid 后,就可以得到该像素属于裂缝的概率。
3. 模型训练
train_set = CrackDataset(
    "slope_crack_dataset/train"
)

train_loader = DataLoader(
    train_set,
    batch_size=8,
    shuffle=True,
    num_workers=0
)

model = UNet()

device = torch.device(
    "cuda" if torch.cuda.is_available() else "cpu"
)

model = model.to(device)

criterion = nn.BCEWithLogitsLoss()

optimizer = torch.optim.Adam(
    model.parameters(),
    lr=0.001
)

for epoch in range(20):

    model.train()
    total_loss = 0

    for images, masks in train_loader:

        images = images.to(device)
        masks = masks.to(device)

        outputs = model(images)

        loss = criterion(outputs, masks)

        optimizer.zero_grad()
        loss.backward()
        optimizer.step()

        total_loss += loss.item()

    print(
        f"Epoch {epoch + 1}: "
        f"Loss = {total_loss / len(train_loader):.4f}"
    )

torch.save(model.state_dict(), "slope_unet.pth")
这里使用的是二元交叉熵损失函数(BCEWithLogitsLoss)。
它会比较模型预测结果与人工标注之间的差异,通过反向传播不断更新网络参数。
需要注意,边坡裂缝通常只占图像中很小的一部分,前景与背景可能严重不平衡。实际训练时,可以进一步尝试 Dice Loss 或 BCE 与 Dice 的组合。
六、模型训练好了,怎么知道它真的识别出了裂缝?
这里有一个很容易被忽略的问题:
训练损失下降,不代表模型就真的学会了裂缝识别。
对于边坡裂缝分割,不能只看准确率(Accuracy)。
因为一张图像中,绝大多数像素可能都是背景。即使模型把所有像素都预测成背景,也可能获得很高的准确率。
所以更适合关注 IoU 和 Dice 等分割指标。
IoU 的计算公式:
$$ IoU=\frac{|P\cap G|}{|P\cup G|} $$
其中:
- (P):模型预测的裂缝区域;
- (G):人工标注的裂缝区域。
IoU 越高,说明预测区域与真实标注区域的重叠程度越高。
除此之外,还需要观察预测掩膜。
如果模型把大量岩石纹理、阴影边界识别成裂缝,即使整体指标不错,也说明模型还存在问题。
可以进一步使用特征图可视化、Grad-CAM 等方法辅助分析模型关注的区域。
但要注意,热力图只能提供一定的解释线索,并不能单独证明模型真正学到了裂缝的物理特征。
还有一个重要细节:训练集和测试集最好按照不同边坡区域、拍摄批次或场景进行划分,而不是简单地随机拆分相邻视频帧。否则,测试结果可能过于乐观。
七、从 CNN 到边坡智能监测,还有多远?
回到最初的问题。
CNN 能够识别边坡裂缝,是因为它通过大量标注图像学习到了从像素特征到裂缝类别之间的映射关系。
但裂缝识别只是边坡智能监测的第一步。
如果只输入一张照片,模型最多能够告诉我们当前图像中哪些区域可能存在裂缝。
它还不能直接回答:
- 这条裂缝是否正在扩展?
- 裂缝的宽度有没有发生变化?
- 边坡表面是否出现持续位移?
- 这些变化是否意味着稳定性正在下降?
这些问题需要进一步结合时间序列图像、图像配准、光流、DIC 以及边坡稳定性分析等方法。
例如,可以先利用 U-Net 提取裂缝区域,再通过连续图像配准分析裂缝的变化情况,进一步提取裂缝长度、开口变化和扩展速度等指标。
这样,研究就从单张图像的静态识别,逐步延伸到了边坡裂缝的动态演化分析。
这也是我认为计算机视觉与边坡研究结合时,一个值得深入探索的方向。
CNN 解决的是如何从图像中提取特征,而边坡研究真正关心的,是这些特征背后反映了什么样的变形与失稳过程。
让机器能够识别裂缝,只是开始;让识别结果真正服务于边坡监测与稳定性分析,才是更值得研究的事情。